I1 — Algorithmes et complexité
Objectif du chapitre. Apprendre à concevoir des algorithmes (recherche séquentielle et dichotomique, tris par insertion et fusion), à introduire la récursivité (le tri fusion en dépend) et à évaluer la complexité d'un algorithme en grand . Ce chapitre porte les deux capacités exigibles de l'IPT : I1.dichotomie et I1.complexite-algorithme.
Ce chapitre suppose les bases de Python du chapitre I1 — Bases Python et représentation des nombres (variables, boucles, fonctions, listes).
Notions
1. La récursivité (introduction)
Avant d'aborder le tri fusion, il faut comprendre la récursivité : une fonction récursive est une fonction qui s'appelle elle-même pour résoudre un sous-problème plus petit. Deux ingrédients sont indispensables :
- un cas de base (la condition d'arrêt, sans laquelle la récursion ne s'arrête jamais) ;
- un pas récursif qui réduit le problème à un cas plus petit (qui doit tendre vers le cas de base).
Exemple : factorielle. , avec .
def factorielle(n):
    if n == 0:          # cas de base
        return 1
    return n * factorielle(n - 1)   # pas récursif : problème plus petit
factorielle(4) déroule en 4 * factorielle(3) = 4 * 3 * factorielle(2) = 4 * 3 * 2 * factorielle(1) = 4 * 3 * 2 * 1 * factorielle(0) = 24. Chaque appel réduit de 1 jusqu'au cas de base .
Exemple : somme d'une liste (récursif).
def somme(lst):
    if len(lst) == 0:            # cas de base
        return 0
    return lst[0] + somme(lst[1:])   # premier élément + somme du reste
Sans cas de base (ou si le pas récursif ne réduit pas le problème), la récursion ne s'arrête jamais : on épuise la pile d'appels (erreur RecursionError en Python). Il faut toujours vérifier que le pas récursif converge vers le cas de base.
2. Recherche séquentielle et dichotomique
Recherche séquentielle. La recherche séquentielle (linéaire) parcourt la liste élément par élément ; la complexité est (au pire : comparaisons) ; elle fonctionne sur une liste non triée.
Recherche dichotomique. La recherche dichotomique (binaire) divise l'intervalle de recherche en deux à chaque itération ; elle exige une liste triée ; la complexité est (au pire : comparaisons) ; à chaque étape, on compare l'élément central à la valeur cherchée et on élimine la moitié de l'intervalle.
Exemple (dichotomie).
def recherche_dichotomique(lst, x):
    a, b = 0, len(lst) - 1
    while a <= b:
        m = (a + b) // 2
        if lst[m] == x:
            return m
        elif lst[m] < x:
            a = m + 1
        else:
            b = m - 1
    return -1
La complexité est : pour , au plus comparaisons (contre pour la recherche séquentielle).
Déroulé pas à pas. Cherchons dans lst = [2, 5, 8, 12, 16, 23, 38, 45] () :
| Étape | lst[m] | Comparaison | Action | |||
|---|---|---|---|---|---|---|
| 1 | 0 | 7 | 3 | 12 | (moitié droite) | |
| 2 | 4 | 7 | 5 | 23 | trouvé à l'indice 5 |
En 2 étapes (au lieu de 6 pour la séquentielle), l'algorithme a trouvé 23. À chaque étape, l'intervalle est divisé par 2 : c'est pourquoi le nombre d'étapes est .
3. Tris : insertion et fusion
Tri par insertion. Le tri par insertion insère chaque élément à sa place dans la partie triée ; la complexité est (au pire) mais si la liste est déjà triée ; c'est un tri stable (il préserve l'ordre des éléments égaux) et in place.
def tri_insertion(lst):
    for i in range(1, len(lst)):
        key = lst[i]
        j = i - 1
        while j >= 0 and lst[j] > key:
            lst[j + 1] = lst[j]
            j -= 1
        lst[j + 1] = key
    return lst
Tri fusion (merge sort). Le tri fusion divise la liste en deux moitiés, trie récursivement chaque moitié (récursivité du §1), puis fusionne les deux moitiés triées. La complexité est toujours (au pire). C'est le premier exemple de récursion utile que l'on utilise :
def tri_fusion(lst):
    if len(lst) <= 1:              # cas de base : liste de 0 ou 1 élément déjà triée
        return lst
    milieu = len(lst) // 2
    gauche = tri_fusion(lst[:milieu])      # tri récursif de la moitié gauche
    droite = tri_fusion(lst[milieu:])      # tri récursif de la moitié droite
    return fusion(gauche, droite)          # fusion des deux moitiés triées

def fusion(g, d):
    res = []
    i = j = 0
    while i < len(g) and j < len(d):
        if g[i] <= d[j]:
            res.append(g[i]); i += 1
        else:
            res.append(d[j]); j += 1
    res.extend(g[i:])   # reste éventuel de g
    res.extend(d[j:])   # reste éventuel de d
    return res
Déroulé pas à pas. Trions [5, 2, 4, 1] :
- Diviser :
[5, 2, 4, 1]→[5, 2]et[4, 1]. - Diviser :
[5, 2]→[5]et[2];[4, 1]→[4]et[1]. - Fusionner (cas de base, listes de 1 élément) :
[5]+[2]→[2, 5];[4]+[1]→[1, 4]. - Fusionner :
[2, 5]+[1, 4]→ comparer et (prendre ), et (prendre ), et (prendre ), reste →[1, 2, 4, 5].
Le tri fusion est stable et en indépendamment de l'état initial de la liste (contrairement à l'insertion).
Tri rapide (complément). Le tri rapide (quick sort, hors programme) choisit un pivot, partitionne, puis trie récursivement ; la complexité est en moyenne mais au pire.
4. Complexité des algorithmes
La complexité mesure le nombre d'opérations élémentaires (ou le temps) en fonction de la taille de l'entrée ; on utilise la notation asymptotique (grand , , ) ; les complexités usuelles (de la plus rapide à la plus lente) sont : (constant), (dichotomie), (recherche linéaire), (tri fusion, rapide), (tri insertion, bulles), (récurrence exponentielle), (permutations).
Règles. La complexité d'un algorithme séquentiel (blocs successifs) est la somme des complexités ; celle d'une boucle de itérations avec un corps en est ; celle d'une récurrence (tri fusion) est — résolution directe : en déroulant la récurrence, ; en prenant (donc ), (le théorème maître — complément — généralise ce calcul) ; on ignore les termes inférieurs et les constantes (la complexité asymptotique caractérise le comportement pour ).
Exemple. Une fonction avec une boucle de itérations où chaque itération appelle une recherche dichotomique sur une liste de éléments : la complexité est (la boucle multipliée par la recherche ) ; si la recherche était séquentielle (), la complexité serait .
Capacités exigibles
- I1.complexite-algorithme — Évaluer la complexité d'un algorithme : identifier les boucles (leur nombre d'itérations en fonction de ) et les appels récursifs ; appliquer les règles (blocs successifs : somme ; boucle de itérations avec corps : ; récurrence : théorème maître — complément) ; exprimer la complexité en grand (en ignorant les termes inférieurs et les constantes) ; comparer les complexités () ; justifier le choix d'un algorithme (par exemple dichotomie vs séquentielle ).
- I1.dichotomie — Implémenter une recherche dichotomique : vérifier que la liste est triée (sinon la recherche échoue) ; initialiser les bornes et ; itérer tant que : calculer le milieu ; comparer
lst[m]à la valeur cherchée ; si égal, retourner ; silst[m] < x, passer à la moitié droite () ; silst[m] > x, passer à la moitié gauche () ; si la boucle se termine sans trouver , retourner ; la complexité est .
Ce qui tombe en colle et en DS
- Implémenter une recherche dichotomique et justifier sa complexité .
- Évaluer la complexité d'un algorithme donné (identifier boucles et récursions, appliquer les règles).
- Comparer deux algorithmes (dichotomie vs séquentielle, fusion vs insertion) et justifier un choix.
Pièges classiques
- Dichotomie : liste triée : la recherche dichotomique exige une liste triée (sinon elle échoue ou renvoie un résultat faux) ; il ne faut pas l'appliquer à une liste non triée ; si la liste n'est pas triée, il faut d'abord la trier () puis rechercher () ; la complexité totale est (dominée par le tri).
- Dichotomie : bornes incluses : la condition de boucle est (pas ) ; il ne faut pas oublier le cas (sinon on manque le dernier élément) ; les mises à jour sont et (pas et , sinon boucle infinie) ; le milieu est (pas , sinon flottant).
- Complexité : somme vs produit : la complexité d'un algorithme séquentiel (blocs successifs) est la somme des complexités ; celle d'une boucle imbriquée est le produit ; il ne faut pas confondre les deux ; par exemple deux boucles successives de itérations : (pas ) ; deux boucles imbriquées : .
- Complexité : constantes ignorées : la complexité asymptotique ignore les constantes et les termes inférieurs ; ; la complexité caractérise le comportement pour (pas le nombre exact d'opérations).
- Récursion : cas de base : sans cas de base (ou si le pas récursif ne réduit pas le problème), la récursion ne s'arrête jamais (
RecursionError) ; il faut toujours vérifier que le pas récursif converge vers le cas de base. - Tri insertion : pire cas : le tri par insertion a une complexité au pire (liste inversée) mais si la liste est déjà triée ; le tri fusion a une complexité toujours (au pire) ; le choix du tri dépend de la taille et de l'état de la liste.
Graphe de référence
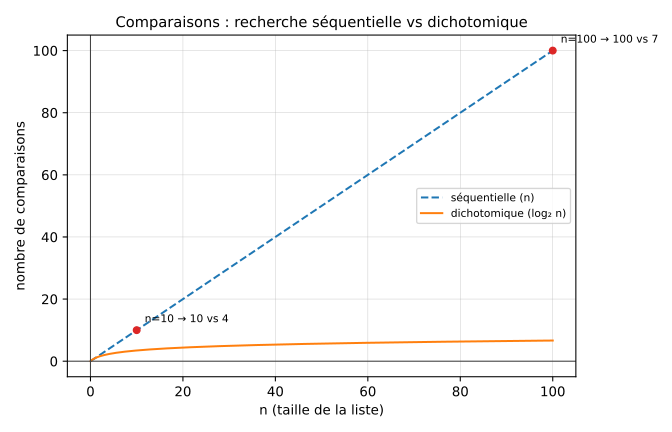
Nombre de comparaisons en fonction de la taille de la liste pour la recherche séquentielle ( comparaisons au pire) et la recherche dichotomique ( comparaisons au pire) : la courbe séquentielle est linéaire () ; la courbe dichotomique est logarithmique () ; pour , la séquentielle fait 1000 comparaisons et la dichotomique en fait 10 ; pour , la séquentielle fait comparaisons et la dichotomique en fait 20 ; la dichotomie est beaucoup plus rapide pour les grandes listes.
Pour aller plus loin
Annales utilisables sur ce chapitre : voir la page générale Ressources, exercices et annales pour les manuels recommandés et les banques d'exercices gratuites.