Brouillon non relu. Ce cours est un brouillon non relu par l'enseignant : le contenu est à faire vérifier avant toute utilisation en classe.
M19 — Variables aléatoires sur un espace fini
Objectif du chapitre. Étudier les variables aléatoires sur un espace fini : les lois usuelles (uniforme, Bernoulli, binomiale), l'espérance, la variance et l'écart-type, la covariance, la variance d'une somme, et les inégalités de Markov et de Bienaymé-Tchebychev. L'objectif est de savoir reconnaître une loi binomiale, calculer l'espérance et la variance d'une somme, et utiliser Tchebychev pour majorer une probabilité.
Soit (Ω,P) un espace probabilisé fini. Une variable aléatoire (v.a.) réelle X est une application X:Ω→R. La loi de X est la liste des valeurs xi prises par X et des probabilités pi=P(X=xi) (avec ∑pi=1).
Fonction d'une variable. Si g:R→R est une fonction, alors g(X) est une v.a. de loi : P(g(X)=y)=∑{i∣g(xi)=y}pi.
Loi uniforme sur {a,…,b} : P(X=k)=b−a+11 pour k∈{a,…,b}. Espérance 2a+b, variance 12(b−a+1)2−1.
Loi de Bernoulli de paramètre p : P(X=1)=p, P(X=0)=1−p. Espérance p, variance p(1−p).
Loi binomialeB(n,p) : somme de n variables de Bernoulli indépendantes de paramètre p. P(X=k)=(kn)pk(1−p)n−k pour k∈{0,…,n} (le coefficient (kn) compte le nombre de suites de n épreuves avec k succès — cf. M17, dénombrement). Espérance np, variance np(1−p).
Reconnaître une loi binomiale. On a une loi binomiale B(n,p) si :
L'expérience se décompose en n épreuves identiques et indépendantes.
Chaque épreuve a deux issues (succès / échec) avec la même probabilité p de succès.
7. Inégalités de Markov et de Bienaymé-Tchebychev
Inégalité de Markov. Si X≥0 et a>0, alors
P(X≥a)≤aE(X).
Inégalité de Bienaymé-Tchebychev. Pour tout a>0,
P(∣X−E(X)∣≥a)≤a2Var(X).
Application. Ces inégalités permettent de majorer une probabilité (de déviation) à partir de l'espérance et de la variance, sans connaître la loi exacte. C'est l'outil de base de la convergence en probabilité et du théorème faible des grands nombres.
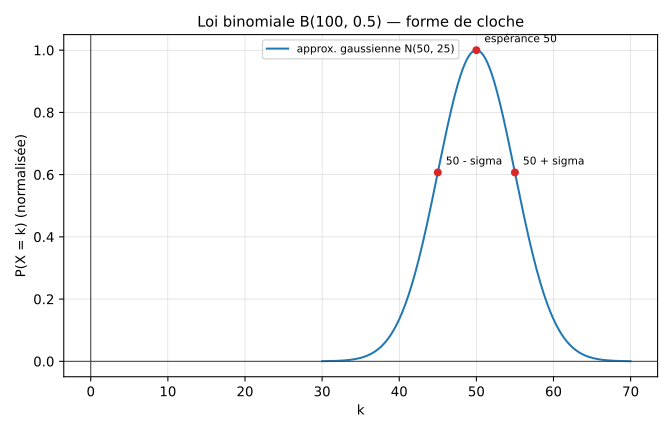
Exemple. Soit X∼B(100,0.5) (lancer 100 fois une pièce équilibrée, X = nombre de faces). E(X)=50, Var(X)=25. Tchebychev donne
P(∣X−50∣≥10)≤10025=0.25.
Donc la probabilité que X s'écarte de 50 de plus de 10 est au plus 25% (la vraie probabilité est bien plus petite, environ 4%, mais Tchebychev donne une majoration générale).
Soient X1,…,Xn des variables aléatoires indépendantes et de même loi (espérance μ, variance σ2<∞), et Sn=n1∑i=1nXi la moyenne empirique. Alors
E(Sn)=μ,Var(Sn)=nσ2.
Conséquence (Tchebychev). Pour tout ε>0,
P(∣Sn−μ∣≥ε)≤nε2σ2n→∞0.
La moyenne empirique converge en probabilité vers l'espérance : c'est le théorème faible des grands nombres. C'est le fondement statistique de la moyenne (la moyenne d'un grand nombre de mesures est proche de la valeur moyenne).
Exemple. On mesure une grandeur n fois, avec des erreurs indépendantes de variance σ2 ; la moyenne des n mesures a une variance σ2/n : en quadruplant le nombre de mesures, on divise l'incertitude par 2 (l'écart-type par 2). C'est le principe de la moyenne mobile et de la répétition des mesures en physique.
9. Fonction d'une variable : espérance et variance
Soit X une v.a. de loi {xi,pi} et g une fonction. La v.a. Y=g(X) a pour espérance E(Y)=∑ig(xi)pi (théorème de transfert). Pour la variance, on calcule E(Y2)=∑ig(xi)2pi puis Var(Y)=E(Y2)−E(Y)2.
Exemple. Soit X uniforme sur {1,2,3} et Y=X2. On a E(Y)=31+4+9=314 et E(Y2)=31+16+81=398 ; donc Var(Y)=398−(314)2=998⋅3−196=998.
Démonstrations exigibles — à savoir refaire : Markov et Tchebychev.Markov : soit X≥0 et a>0. Alors aP(X≥a)≤∑x≥axP(X=x)≤∑xxP(X=x)=E(X), donc P(X≥a)≤E(X)/a. Tchebychev : soit X d'espérance μ et de variance σ2. En appliquant Markov à (X−μ)2≥0 avec a=ε2 : P((X−μ)2≥ε2)≤E((X−μ)2)/ε2=σ2/ε2. Comme (X−μ)2≥ε2⇔∣X−μ∣≥ε, on a P(∣X−μ∣≥ε)≤σ2/ε2 (la loi faible est une application directe de Tchebychev).
M19.esperance-variance — Calculer l'espérance et la variance d'une somme : utiliser la linéarité de l'espérance et la formule Var(X+Y)=Var(X)+Var(Y)+2Cov(X,Y) (avec Cov=0 si indépendance).
Var(X+Y)=Var(X)+Var(Y)+2Cov(X,Y) : il ne faut pas oublier le terme de covariance ; il s'annule seulement si X et Y sont indépendants (ou non corrélés).
L'indépendance annule la covariance : si X et Y sont indépendants, alors Cov(X,Y)=0 ; mais la réciproque est fausse (covariance nulle ⇏ indépendance).
Var(aX+b)=a2Var(X), pas aVar(X)+b : la variance est homogène de degré 2 (le facteur a est au carré) et invariante par translation (le terme b disparaît).
Loi binomiale : indépendance des épreuves : si les épreuves ne sont pas indépendantes, la somme des Bernoulli n'est pas binomiale (même si l'espérance et la variance coïncident, la loi diffère).
Théorème de transfert : on applique g aux valeurs : E(g(X))=∑g(xi)pi (pas ∑g(xi)g(pi)) ; la fonction g s'applique aux valeurs de X, pas aux probabilités.
Tchebychev : c'est une majoration, pas une égalité : l'inégalité donne un borne supérieure ; la vraie probabilité peut être bien plus petite (surtout pour les lois concentrées).
La loi binomiale B(100,0.5) (lancer 100 fois une pièce) est concentrée autour de son espérance 50 avec un écart-type 25=5 ; la courbe (k100)2−100 (en fonction de k) montre la « forme de cloche » (l'approximation normale de la binomiale est un complément hors programme, à connaître comme culture).